
2026-09-30 · 안원석
#xKanban · #AI Agent · #Vibecoding · #Context · #AI
“회의실 예약 앱 하나 만들어 줘.”
잠시 뒤 화면이 뜹니다. 날짜를 고르고 버튼을 누르면 예약까지 됩니다. 머릿속 아이디어가 눈앞에서 바로 움직이는 경험. 사람들이 바이브 코딩에 빠져든 이유는 이것 하나로 충분히 설명됩니다.
그런데 팀원들이 이 앱을 실제로 쓰기 시작하면 이야기가 달라집니다. 두 사람이 같은 시간을 동시에 예약하면 어떻게 될까요? 퇴사한 사람의 권한은 누가 거둬야 할까요? 지난달에 막아 둔 문제가 이번 수정으로 다시 살아난다면 어떻게 될까요? 이제는 첫 화면을 얼마나 빨리 만드느냐보다, 시간이 지나도 프로젝트를 이해하고 고칠 수 있느냐가 더 중요해집니다.
이 글에서는 AI 코딩 도구가 어떻게 여기까지 왔는지 짚어 보고, AI가 지난 일을 기억하면서도 제대로 판단하게 하려면 무엇이 필요한지 살펴봅니다. 마지막으로 xKanban이 이 문제를 어떻게 풀고 있는지, 사람과 에이전트가 오래 함께 일하는 모습을 소개하겠습니다.
비유하자면…
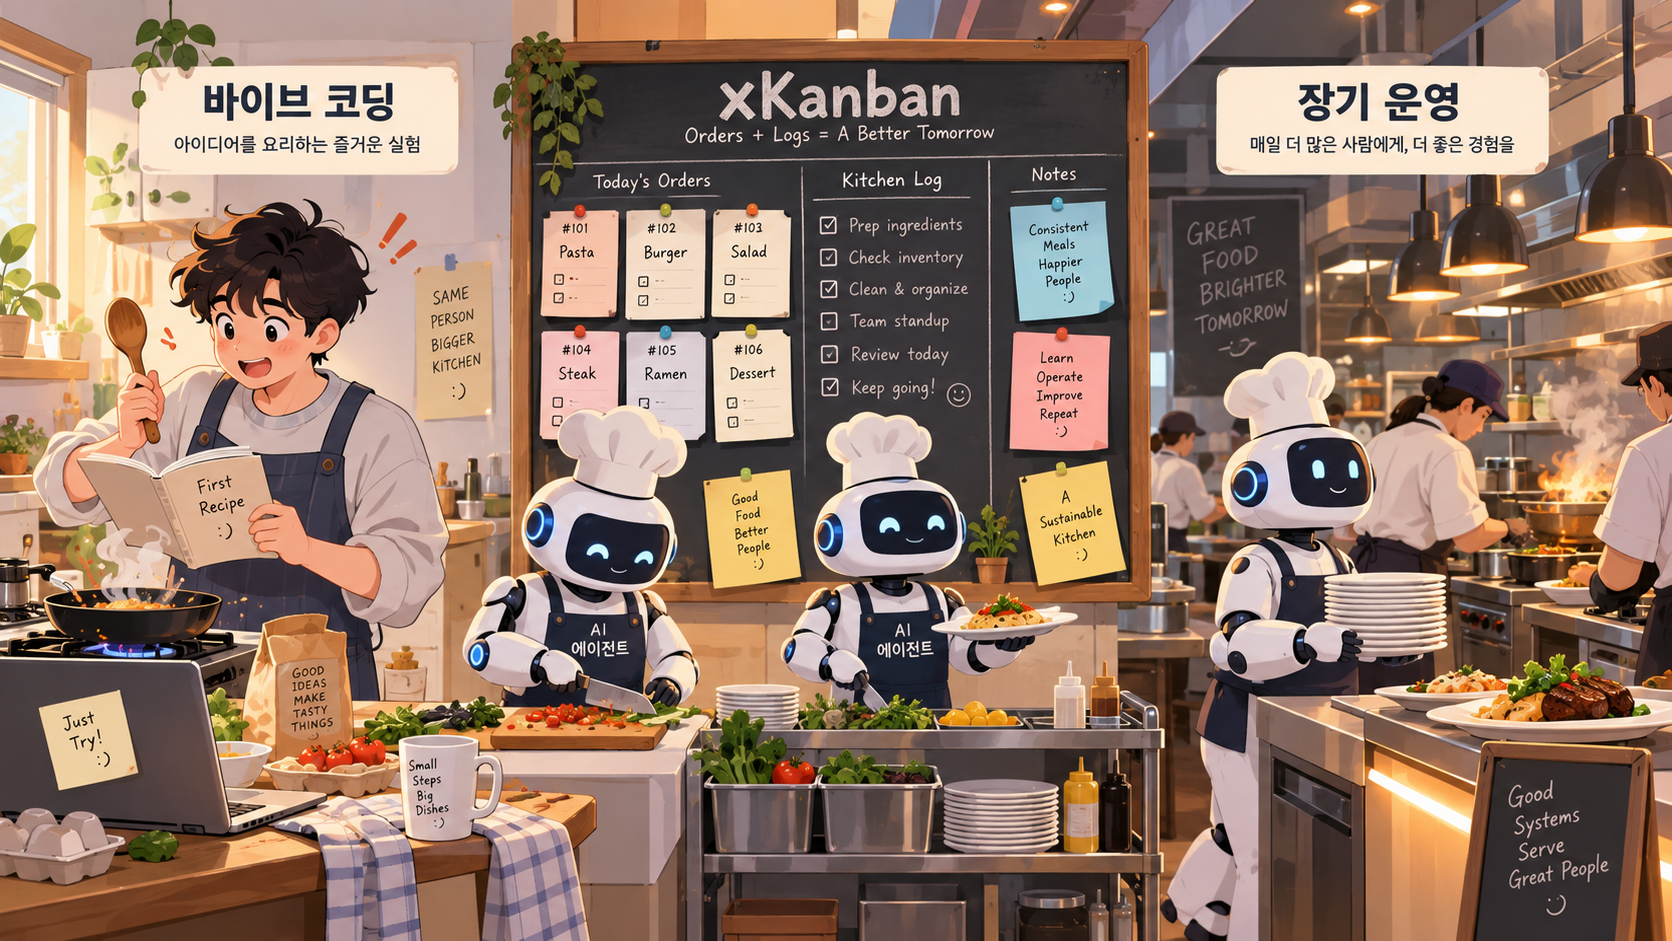
한 끼 요리에서 매일 여는 식당으로. AI 에이전트는 보조 요리사, xKanban은 주문표와 주방 일지를 모은 주방 게시판입니다.
‘코드 추천’에서 ‘일 맡기’까지 - AI의 변천사
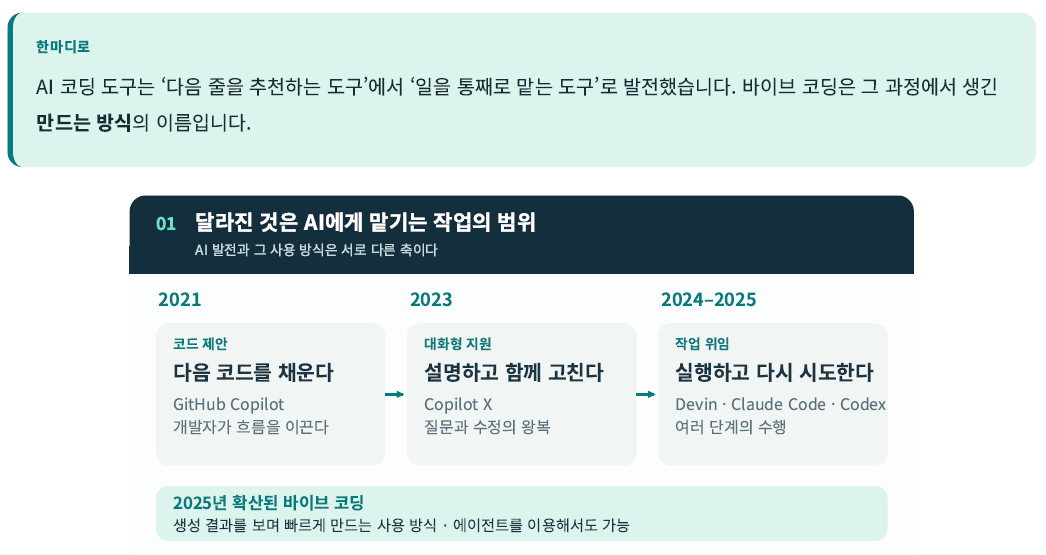
그림1. 제품의 발전과 사용 방식은 별개의 축이다. 공식 발표 자료 [1]–[5]와 용어 논의 [6]을 바탕으로 자체 제작.
코딩 도구의 역사는 사람이 외우고 반복해야 할 일을 하나씩 덜어 준 역사입니다. 편집기는 문법을 알려 줬고, IDE(개발용 종합 편집기)는 코드가 어디에 있고 서로 어떻게 이어지는지 찾아 주었습니다. 생성형 AI는 여기에 “다음에 뭘 쓸까?”를 제안하는 능력을 더했습니다.
- 2021년, 추천하는 AI. GitHub Copilot이 나왔습니다. 개발자가 코드를 쓰면 AI가 다음 줄이나 함수를 제안했습니다. 운전은 사람이 하고, AI는 옆에서 길을 알려 주는 정도였습니다.
- 2023년, 대화하는 AI. GitHub Copilot X가 개발 도구 안에 채팅을 넣었습니다. 코드를 추천받는 데서 그치지 않고, 설명을 듣고, 오류를 묻고, 어떻게 고칠지 함께 이야기할 수 있게 되었습니다.
- 2024~2025년, 일을 맡는 AI. AI가 직접 파일을 읽고 고친 뒤 명령을 실행하고, 테스트가 실패하면 다시 고칩니다. 2024년 3월 Cognition의 Devin이 이런 흐름을 보여 줬고, 2025년 2월 Claude Code 연구 프리뷰와 5월 클라우드 기반 Codex가 나오면서 ‘일을 묶어서 맡기는’ 방향이 뚜렷해졌습니다.
바이브 코딩이라는 말은 이 흐름 한가운데서 나왔습니다. 2025년 2월 Andrej Karpathy는 생성된 코드를 꼼꼼히 읽는 대신, 결과를 보며 말로 고쳐 달라고 해서 주말 프로젝트를 만드는 방식을 이렇게 불렀습니다. Simon Willison은 곧바로 “AI를 쓰는 프로그래밍이 전부 바이브 코딩은 아니다”라며 둘을 구분해야 한다고 짚었습니다.
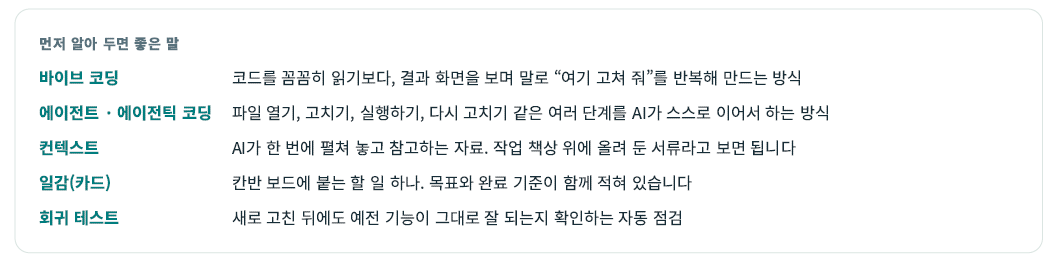
그래서 “바이브 코딩이 먼저 나오고, 그다음에 에이전틱 코딩이 생겼다”는 표현은 맞지 않습니다. 맡은 일을 주도적으로 해낸다는 의미를 가진 "에이전트"는 그 이름이 유행하기 전부터 있었기 때문입니다. 바이브 코딩은 ‘어떻게 만들고 확인하느냐’를 표현하는 말이고, 에이전틱 코딩은 ‘AI가 어디까지 직접 움직이느냐’에 관한 말입니다.
같은 에이전트를 써도 화면만 보며 가볍게 실험할 수 있고, 변경 이유와 테스트를 꼼꼼히 검토하며 제품을 만들 수도 있습니다. 하지만 명심할 점은 AI가 더 많은 일을 스스로 한다고 해서, 결과에 대한 책임까지 대신 져 주지는 않는다는 사실입니다.
비유하자면…
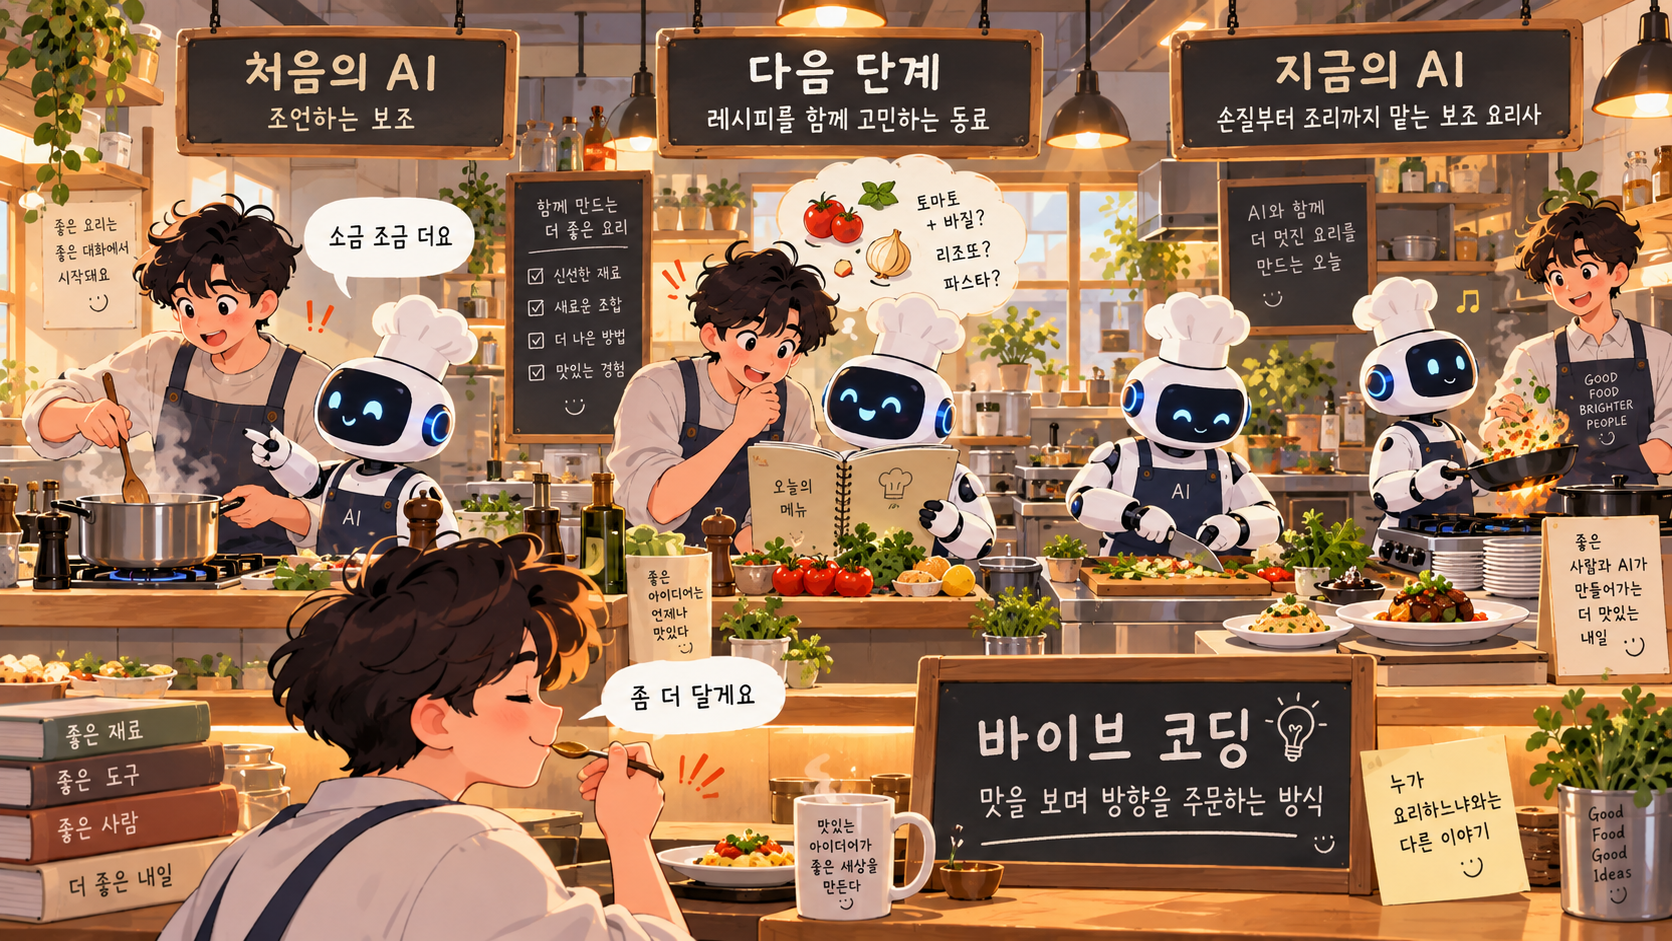
역할에 따라 분류하면, 조언하는 보조 → 레시피를 함께 고민하는 동료 → 조리까지 맡는 보조 요리사. 바이브 코딩은 맛을 보며 방향을 주문하는 방식이라, 누가 요리하느냐와는 다른 이야기입니다.
도구를 고를 때는 ‘무슨 일을 덜어 주는지’부터 봐야 합니다
도구 이름보다 지금 내가 어디서 막혀 있는지가 선택 기준입니다. 처음 만드는 중인지, 있는 코드를 고치는 중인지, 팀이 함께 일을 이어 가는 중인지를 먼저 봐야 합니다.
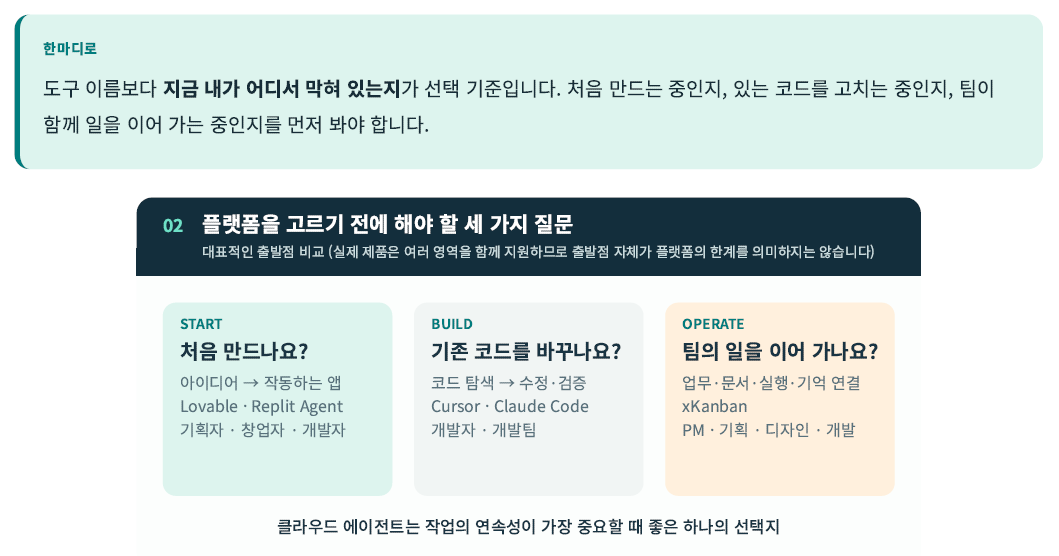
그림2. 도구 선택의 세 가지 관점. 주) 제품 순위나 성능을 나타내는 것이 아닙니다.
도구 이름을 하나하나 기억하기에는 변화가 너무 빠릅니다. 대신 ‘도구가 나 대신 해 주는 일의 단위’를 보면 차이가 잘 보입니다. 아래 표의 구분은 이해를 돕기 위한 것입니다. 실제 제품은 여러 영역을 함께 지원하고 계속 바뀝니다. 누가 쓰느냐도 딱 잘라 나뉘지 않습니다.
Lovable은 말로 웹 앱을 만드는 경험과, 만든 코드를 내 것으로 가져가 외부 저장소와 연결하는 기능을 강조합니다. Replit Agent는 프로젝트 준비, 실행 환경, 구현, 테스트를 한 번에 묶어 줍니다. 이런 도구는 무언가를 새로 시작하는 부담을 크게 줄여 줍니다. 그래서 ‘개발자인가 아닌가’보다 ‘지금 빈 화면에서 시작하는가’가 더 중요한 기준일 수 있습니다.
Cursor와 Claude Code는 이미 있는 코드를 가까이에서 다루려는 사람에게 잘 맞습니다. 편집기 안에서 일하는 게 편한지, 터미널에서 여러 도구를 폭넓게 연결하는 게 편한지에 따라 고르면 됩니다. Grok Bot, Google Spark, OpenAI Dots같은 클라우드 에이전트는 일을 맡겨 놓고 다른 일을 하다가, 나중에 변경안과 실행 결과를 검토하는 방식에 어울립니다.
그렇다고 “입문용 도구는 실무에 못 쓴다”는 뜻은 아닙니다. 앱 제작 도구도 팀 기능을 늘리고 있고, 전문 개발 도구도 초보자의 실험에 쓰입니다. 정말 물어야 할 건 이것입니다. 지금 막힌 곳이 ‘시작하기’인가, ‘코드 고치기’인가, 아니면 ‘여러 사람이 같은 맥락을 맞추는 일’인가? xKanban은 이 마지막 질문에 답하려는 도구입니다.
비유하자면...
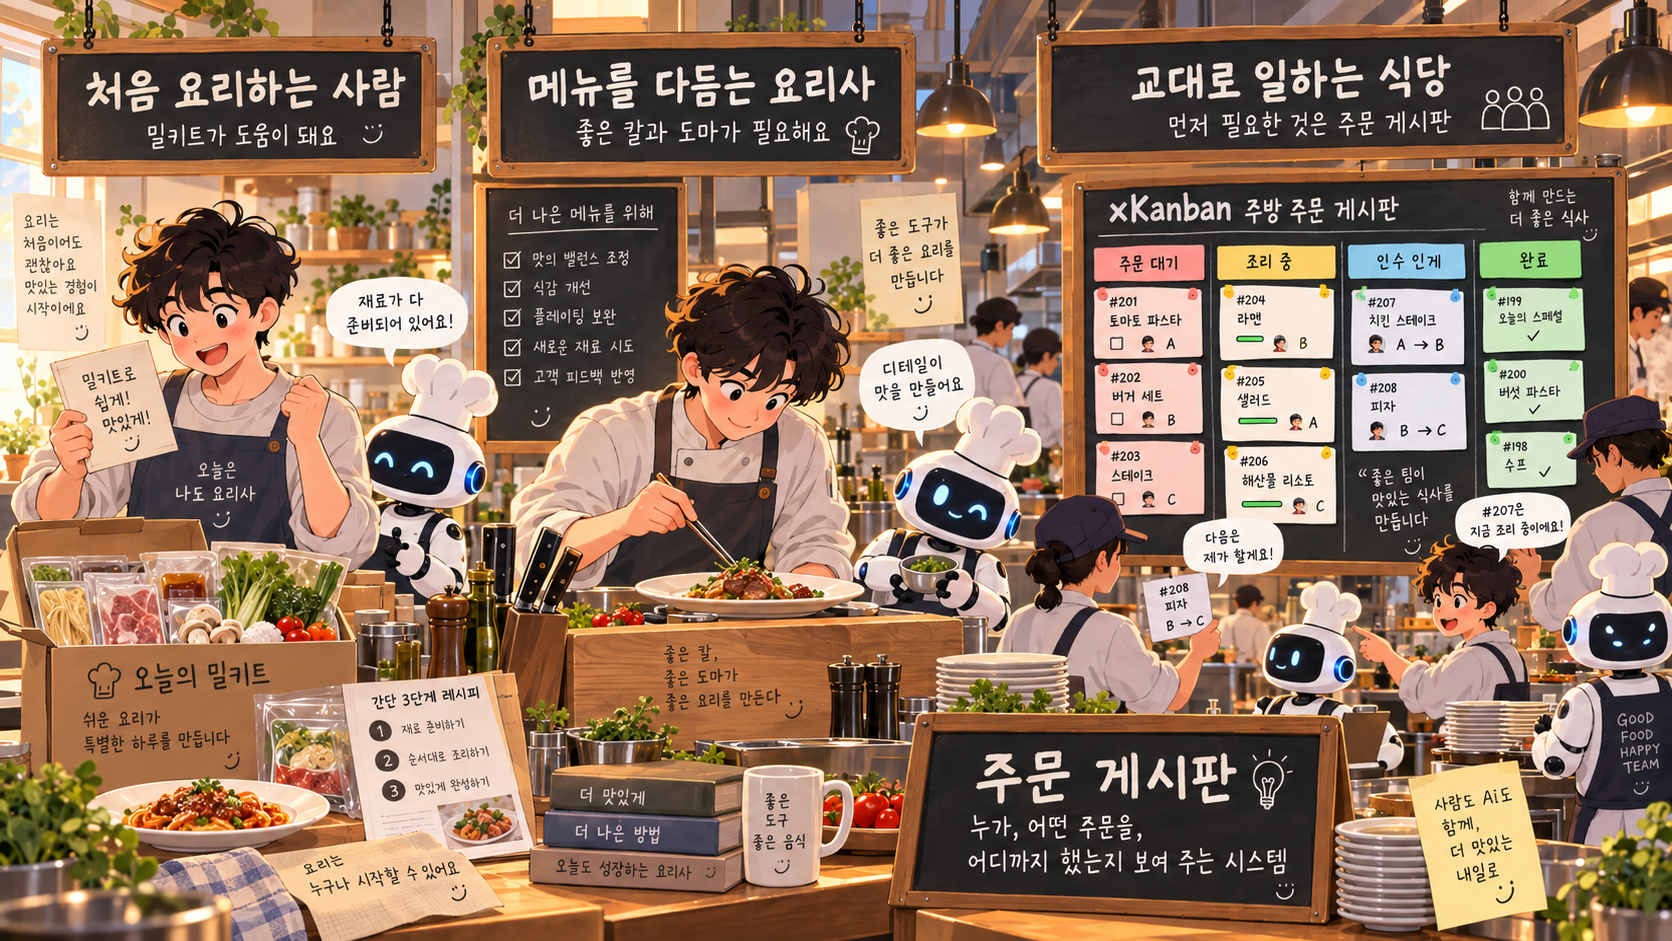
처음 요리하는 사람에겐 밀키트, 메뉴를 다듬는 요리사에겐 좋은 도구, 교대로 일하는 식당엔 주문 게시판이 먼저 필요합니다. 하지만 전문 요리사도 밀키트로 음식을 만들어 먹기도 하고, 처음 요리하는 사람이 좋은 요리 도구를 사용하지 못할 이유는 없습니다.
앞으로의 변화는 ‘더 많이 맡기기’만으로는 설명이 안 됩니다
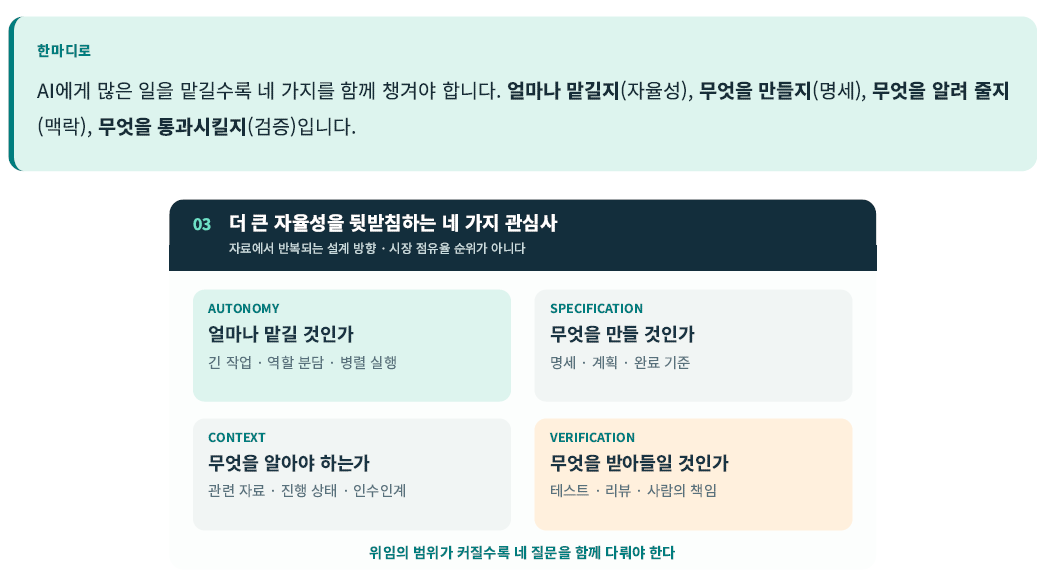
그림 3. 에이전트 발전을 바라보는 네 가지 관점. [11]–[14]와 [18]을 참고해 자체 제작.
에이전틱 코딩의 미래를 두고 회사와 전문가마다 강조하는 점이 조금씩 다릅니다.
- 더 오래, 더 많이 맡기자. Cursor는 2026년 1월, 여러 에이전트를 오래 돌리는 실험을 공개했습니다. 모두에게 같은 일을 시키자 서로 부딪히는 문제가 생겼고, ‘계획하는 역할’과 ‘실행하는 역할’을 나누자 나아졌다고 합니다. 다만 이건 한 회사의 연구 사례입니다. 에이전트를 늘리면 생산성도 늘 그만큼 오른다는 증거는 아닙니다.
- 사람이 이해하고 책임지자. Willison은 AI가 만든 코드라도 사람이 설명할 수 있어야 한다고 말합니다. Martin Fowler는 에이전트가 코드를 쓰더라도 사람이 구조와 동작을 책임지는 방향성을 바이브 코딩과 같은 개발 방식과는 별개의 문제로 봅니다. 직접 치는 코드가 줄어도, 무엇을 만들고 어떤 결과를 받아들일지 정하는 능력은 여전히 필요하다는 뜻입니다.
- 명세(무엇을 만들지 적은 설계서)를 중심에 두자. GitHub의 Spec Kit는 요구 사항을 명세 → 계획 → 작업으로 구체화하고, 그 내용이 구현까지 이어지도록 돕습니다. 다만 명세를 많이 쓰는 것 자체가 목표가 되면 관리할 문서만 늘어납니다. 요구가 바뀔 때 명세와 코드가 함께 고쳐지는지가 더 중요합니다.
- 단순하게 시작하고, 일하기 좋은 환경을 만들자. Anthropic은 꼭 필요한 도구와 흐름으로 시작하고, 복잡하게 만들 이유가 확인될 때만 더하라고 권합니다. 오래 걸리는 작업을 다룬 연구에서도 진행 기록, 기능 목록, 검증 결과를 다음 세션에 넘겨주는 설계를 중요하게 다룹니다.
생산성 연구도 조건을 함께 봐야 합니다. METR의 2025년 연구에서는 숙련 개발자 16명이 자기에게 익숙한 오픈 소스 저장소에서 246개 작업을 했는데, 당시 AI 도구를 쓴 쪽이 평균 19% 더 오래 걸렸습니다. 모든 개발 작업에 해당하는 결론은 아닙니다. 2026년 후속 보고에서는 도구의 도움이 커졌을 가능성을 언급하면서도, 참여자와 작업이 골라지는 과정의 편향 때문에 효과가 얼마나 큰지 믿을 만하게 추정하기 어렵다고 밝혔습니다.
이 자료들을 모아 보면 방향은 보입니다. AI에게 맡기는 일이 커질수록 목표, 맥락, 진행 상태, 검증을 함께 관리하는 일이 중요해집니다. 시장 점유율로 증명된 ‘대세’라기보다, 여러 제품과 연구에서 되풀이되는 설계 방향입니다. 더 많이 맡기는 흐름과 그 일을 더 꼼꼼히 관리하는 흐름이 함께 가고 있는 것입니다.
비유하자면...
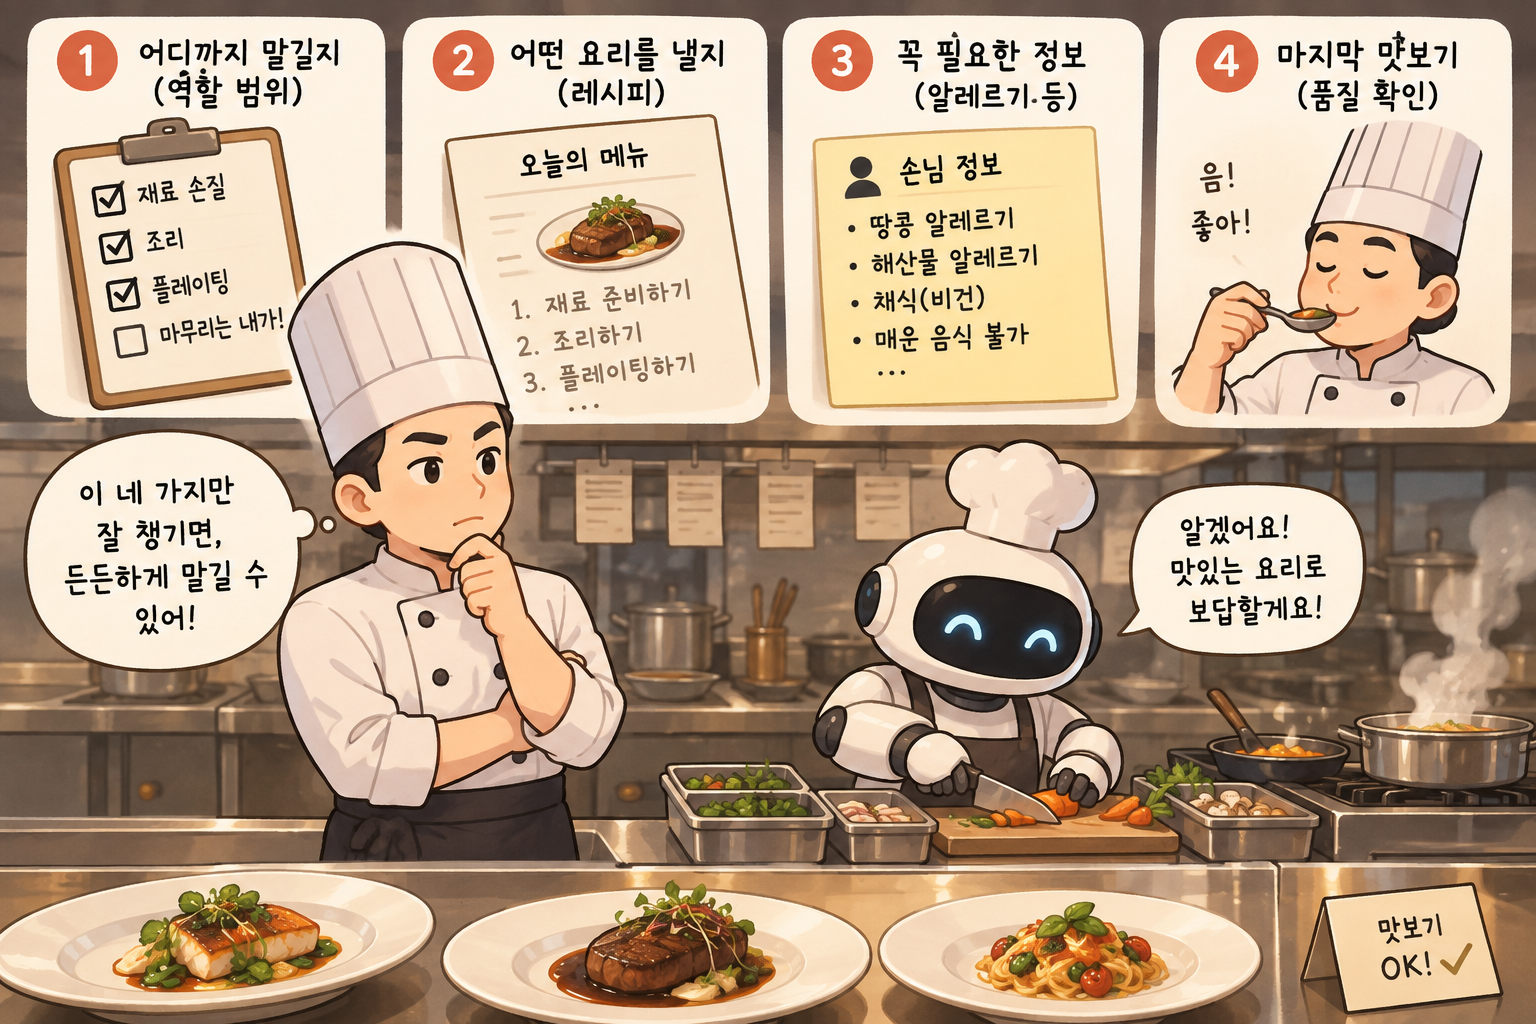
어디까지 맡길지, 어떤 요리를 낼지, 꼭 필요한 정보, 마지막 맛보기. 이 넷을 챙겨야 든든하게 맡길 수 있습니다.
처음 만들 때의 성공과 계속 운영할 때의 성공은 다릅니다
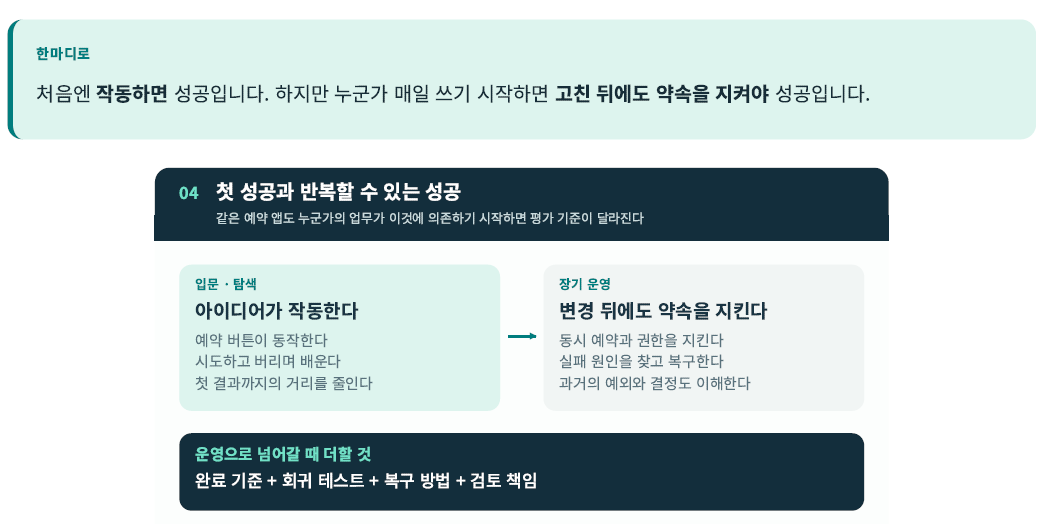
그림 4. 입문과 운영의 성공 기준. 회의실 예약 앱은 설명을 위한 예시.
바이브 코딩의 재미를 낮춰 볼 이유는 없습니다. 새 분야를 배우는 사람에게 가장 큰 벽은 첫 결과를 보기까지의 거리입니다. 작은 도구라도 직접 돌려 보면 데이터베이스, 로그인, 배포 같은 낯선 개념이 궁금해지기 시작합니다. 경험 많은 개발자도 짧은 실험으로 새 기술의 감을 잡을 수 있습니다.
처음의 회의실 예약 앱으로 돌아가 보겠습니다. 혼자 시연할 땐 예약 버튼만 눌리면 성공입니다. 그런데 쓰는 사람이 늘수록 성공의 기준이 올라갑니다.
- 팀이 쓰기 시작하면 같은 시간에 두 사람이 예약하지 못하게 막아야 합니다.
- 여러 부서가 쓰면 관리자 권한, 취소 규칙, 외부 캘린더 연동이 필요합니다.
- 반년이 지나면 “그때 이 예약을 왜 예외로 허용했지?”까지 알아야 합니다.
기능이 하나 늘 때마다 챙겨야 할 연결 고리도 늘어납니다. 취소 규칙은 알림을 보내는 시점에 영향을 주고, 알림을 다시 보내는 기능은 같은 알림이 두 번 가는 문제와 이어집니다. 권한을 바꾸면 화면뿐 아니라 API(프로그램끼리 주고받는 창구)와 과거 기록을 누가 볼 수 있는지도 달라집니다. 코드는 짧아도 관계는 복잡할 수 있습니다.
이 차이는 프로젝트 크기로 정해지지 않습니다. 작은 사내 도구라도 누군가 매일 그걸로 일한다면 운영 책임이 생깁니다. 반대로 큰 시제품이라도 쓰고 버릴 예정이라면 운영 체계를 다 갖출 필요는 없습니다.
‘이제 운영이다’ 싶은 시점에는 몇 가지만 바꾸면 됩니다. 중요한 동작은 테스트로 고정하고, 데이터를 되돌릴 방법을 마련하고, 변경을 검토할 사람을 정합니다.
AI에게 일을 줄 때도 “예약 기능 만들어 줘”에서 한 걸음 더 나아가야 합니다. “기존 예약과 권한 규칙은 그대로 두고 고쳐 줘. 동시 예약과 취소 알림이 잘 되는지도 확인해 줘.”처럼 요청하는 것입니다.
빠르게 시작하는 건 좋은 출발입니다. 오래 버티는 힘은 그 위에 일부러 쌓아야 생깁니다. 운영을 시작했다고 실험을 멈출 필요도 없습니다. 실험하는 공간과 운영하는 기준을 나눠 두면, 새로운 시도를 계속하면서도 사용자와의 약속을 지킬 수 있습니다.
비유하자면...
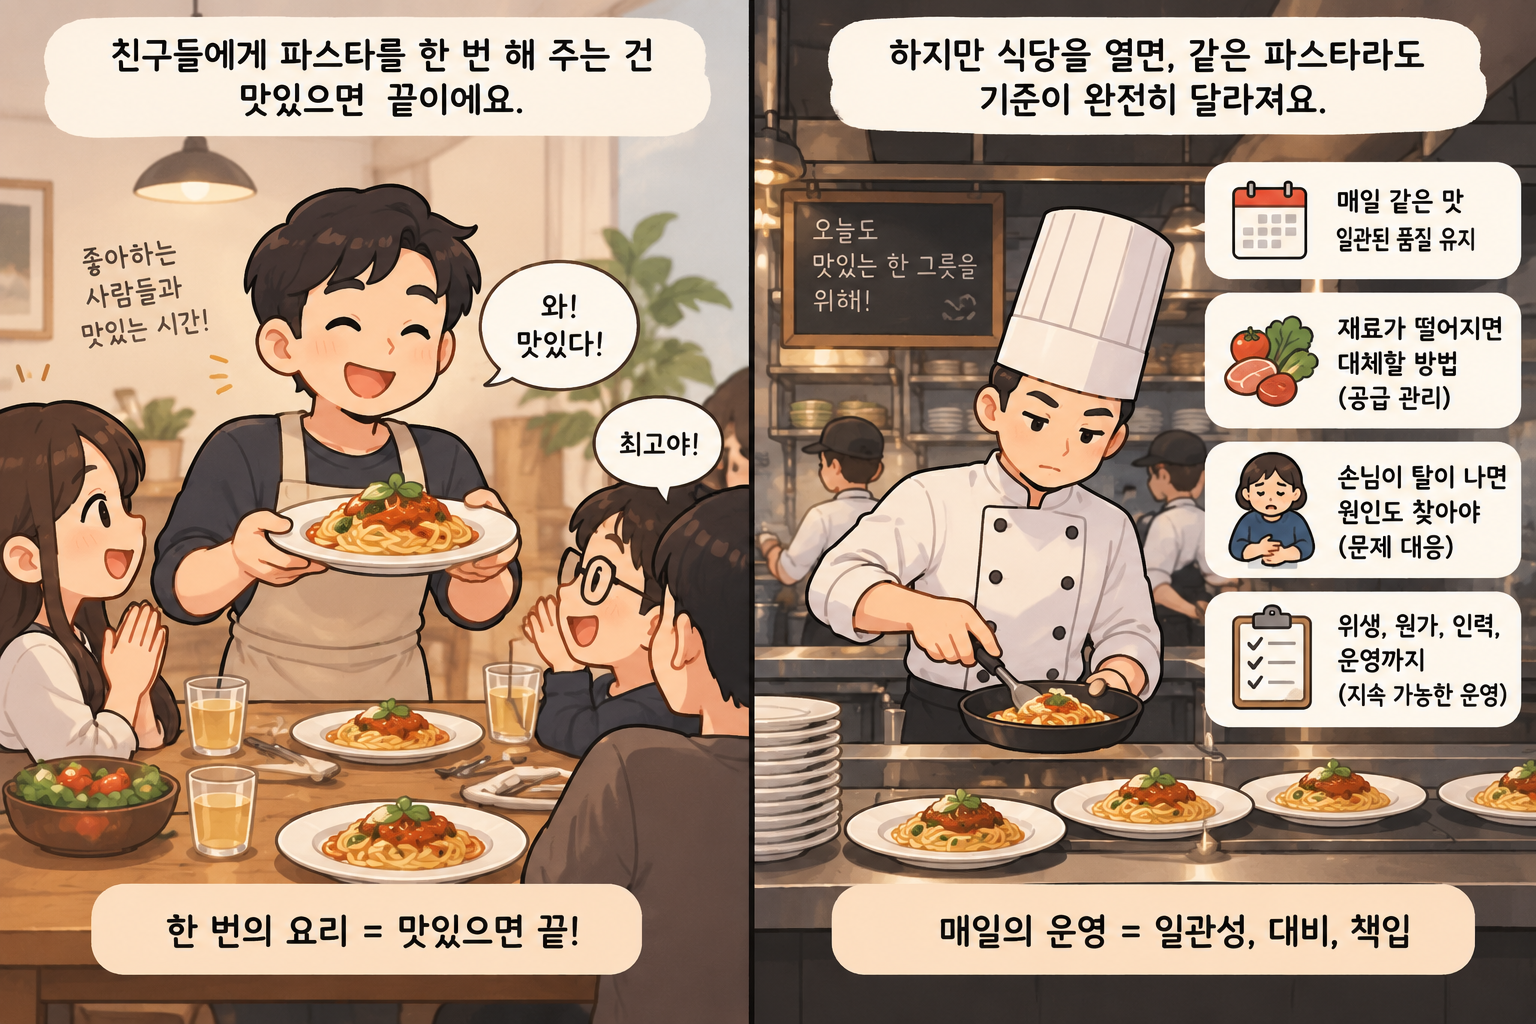
한 번의 요리는 맛있으면 끝이지만, 매일의 운영에는 일관성, 대비, 책임이 필요합니다.
프로젝트가 커질수록 지난 일을 ‘쓸 수 있는 지식’으로 바꿔야 합니다
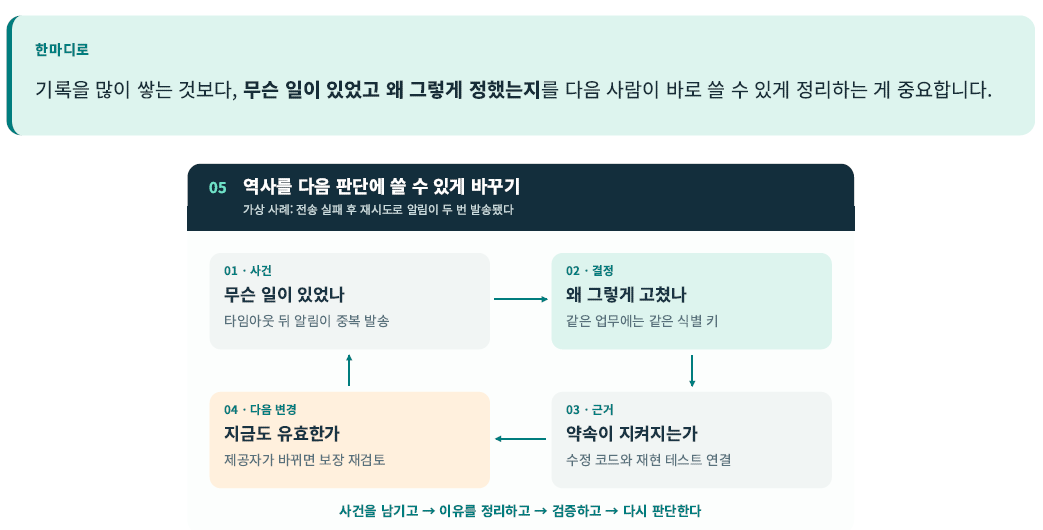
그림 5. 사례가 재사용할 지식이 되는 과정. 예약 앱의 가상 사례를 바탕으로 자체 제작.
오래된 코드에는 처음 보는 사람 눈에 이상해 보이는 부분이 있습니다. 괜히 한 번 더 확인하는 절차, 중복처럼 보이는 처리, 좀처럼 지우지 않는 상태 값 같은 것들입니다. 그중 일부는 정리해야 할 찌꺼기지만, 일부는 실제 사고를 겪고 나서 만든 안전장치입니다.
예를 들어 AI가 “알림 보내는 코드가 복잡하니 단순하게 바꾸자”고 제안했다고 해 보겠습니다. 코드는 깔끔해졌는데, 알림이 두 번 가지 않게 막던 식별 키까지 사라졌습니다. 예전에 전송이 실패해 다시 보내다가 같은 알림이 두 번 나간 사고가 있었다는 걸 모르면, 그 키가 왜 필요한지 알아보기 어렵습니다.
이런 일을 막으려고 모든 채팅과 로그를 저장해 둘 수도 있습니다. 하지만 쌓인 양이 많다고 다음 사람이 이유를 이해하는 건 아닙니다. “그때 여러 번 논의했다”와 “다시 보낼 때도 알림은 한 번만 가야 한다” 사이에는 정리하는 과정이 필요합니다.
이 사례를 지식으로 남긴다면 이렇게 정리하면 좋습니다.
✓ 사건: 전송 시간이 초과된 뒤 다시 보내다가 같은 알림이 두 번 나갔습니다.
✓ 판단: 전송 요청마다 ‘같은 업무’임을 알아볼 수 있는 키를 붙입니다.
✓ 범위: 알림 발송과 재시도 과정에 적용합니다.
✓ 근거: 해당 장애 기록, 수정한 코드, 문제를 재현하는 테스트를 연결합니다.
✓ 다시 볼 조건: 알림 전송 업체가 바뀌면 중복 방지가 여전히 되는지 다시 확인합니다.
이렇게 남긴 기록은 과거를 기억하는 동시에 다음 변경의 기준이 됩니다. 이슈와 커밋은 ‘무슨 일이 있었는지’를, 결정 기록은 ‘왜 그렇게 했는지’를, 테스트는 ‘그 약속이 아직 지켜지는지’를 보여 줍니다. 셋 중 하나만으로는 나머지를 대신하기 어렵습니다.
Anthropic의 장시간 에이전트 연구도 비슷한 방법을 제안합니다. 새 세션이 진행 파일과 Git 이력을 보고 작업 상태를 파악하고, 작은 단위로 일을 진행한 뒤, 다음 세션을 위해 알아보기 쉬운 흔적을 남기는 방식입니다. 대화 한 번을 넘어 일이 이어지려면 이런 인수인계가 필요합니다.
그렇다고 예전 결정을 영원히 따르라는 뜻은 아닙니다. 그때의 제약이 사라지면 결정도 바꿀 수 있어야 합니다. 다만 어떤 약속을 바꾸는지는 알고 바꿔야 합니다.
예전 결정을 지우기보다 ‘새 결정이 무엇을 대신하는지’ 연결해 두면, 팀이 같은 논쟁을 처음부터 되풀이하지 않아도 됩니다.
기록이 얼마나 오래됐느냐보다, 다음 판단에 바로 쓸 수 있는 모양으로 남아 있느냐가 중요합니다. 새로 온 동료에게도, 새로 시작하는 에이전트 세션에게도 똑같이 도움이 됩니다.
비유하자면...
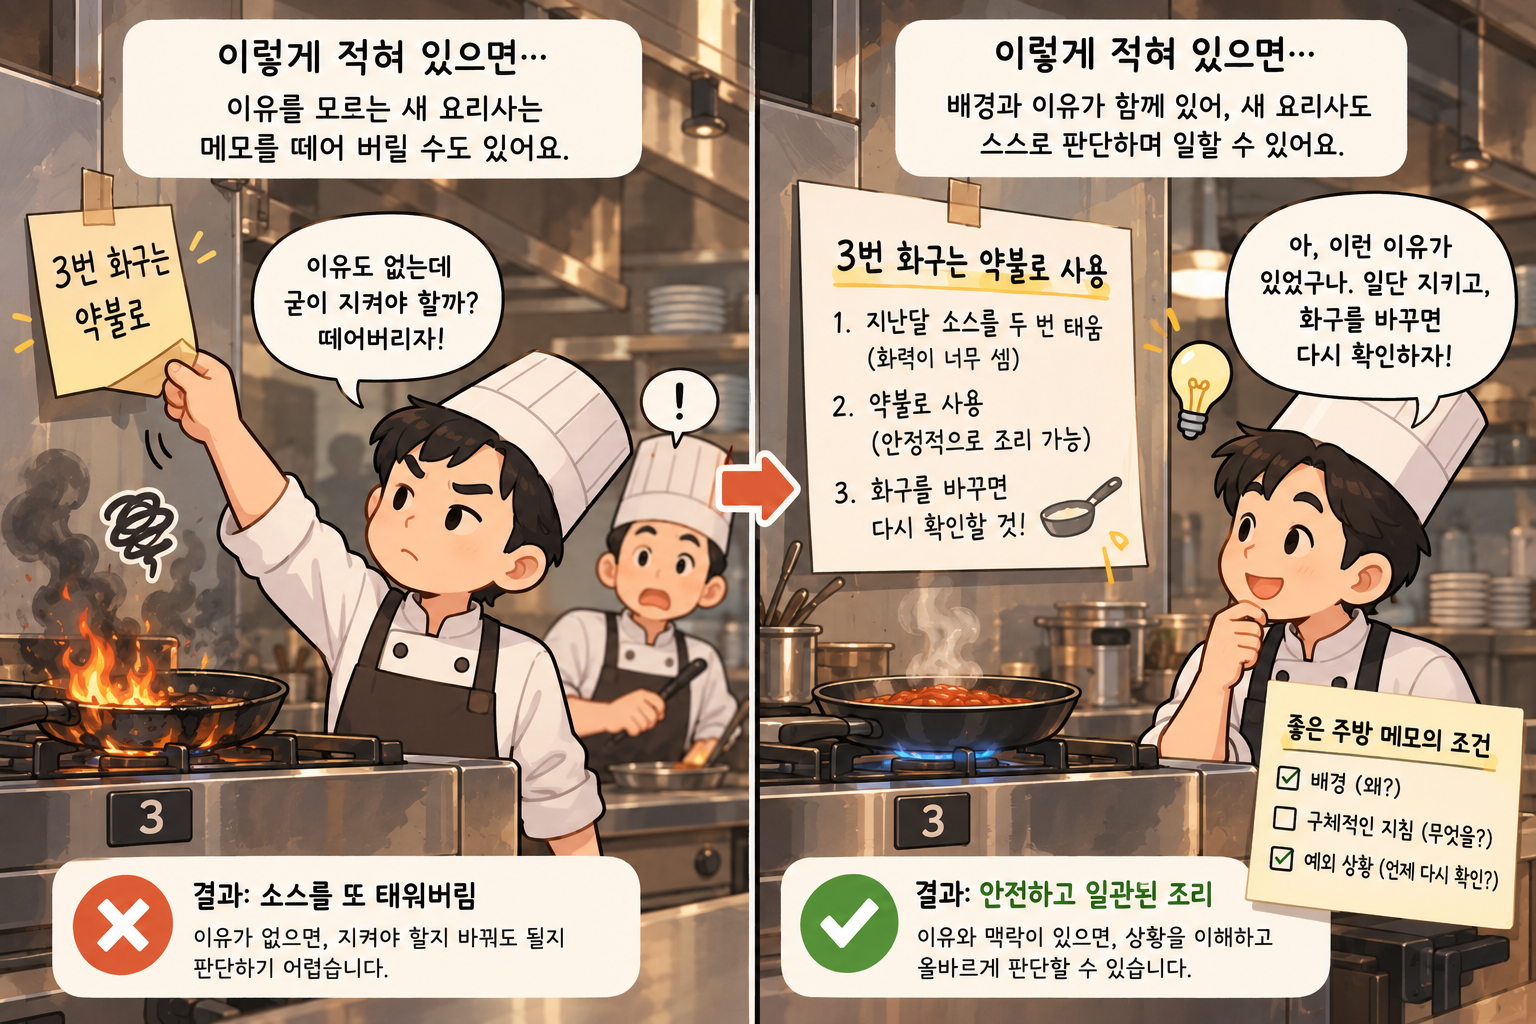
이유 없는 메모는 떼어지고, 배경과 다시 확인할 조건이 함께 적힌 메모는 지켜집니다.
많이 기억하는 것과 잘 판단하는 것은 다릅니다
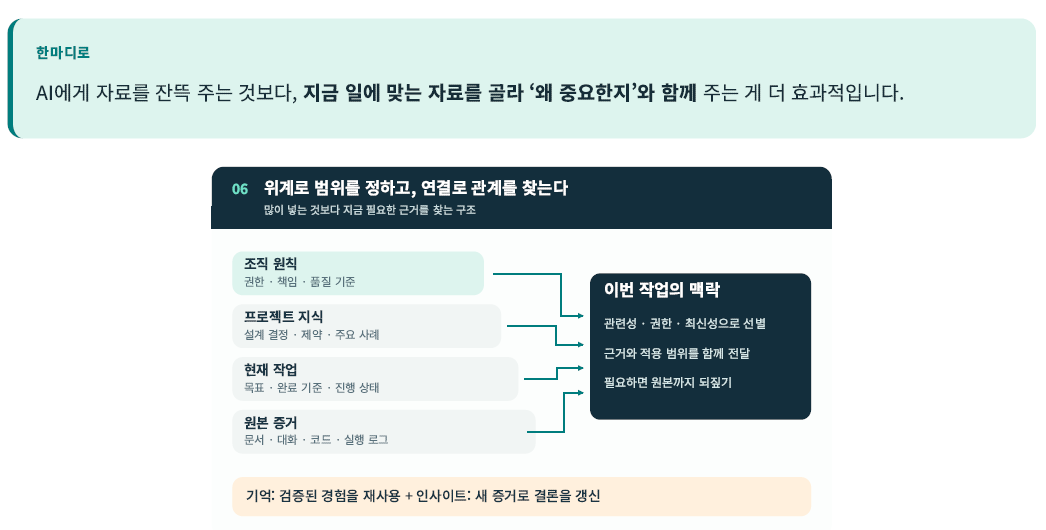
그림 6. 위계는 정보의 범위를, 연결은 영향 관계를 보여 준다. [17][19]를 참고한 자체 설계 제안.
컨텍스트 창은 AI가 한 번에 자료를 펼쳐 놓는 작업 책상과 비슷합니다. 책상이 넓어지면 더 많은 자료를 펼칠 수 있습니다. 그렇다고 어떤 문서가 아직 유효한지, 어떤 예외가 지금 일에 해당하는지까지 저절로 정리되지는 않습니다.
2023년 ‘Lost in the Middle’ 연구는 당시 모델들이 긴 입력 속에서 중요한 정보가 어디에 있느냐에 따라 성능이 달라진다는 걸 보여 주었습니다. 이걸 지금의 모든 모델이 똑같이 실패한다는 뜻으로 넓혀 읽으면 안 됩니다. 다만 ‘넣을 수 있는 양’과 ‘실제로 잘 쓰는 능력’은 따로 봐야 한다는 점은 잘 보여 줍니다.
Anthropic도 컨텍스트를 한정된 자원으로 보고, 필요할 때 관련 자료를 불러와 정리하는 방법을 권합니다.
오래가는 프로젝트에서는 정보를 층과 수명에 따라 나누면 편합니다. 조직의 권한 원칙은 오래 유지됩니다. 프로젝트의 설계 결정은 몇 달 뒤 다시 볼 수 있습니다. 이번 일감의 계획은 오늘도 바뀔 수 있습니다. 실행 로그는 판단의 근거지만 매번 전부 읽을 필요는 없습니다.
폴더만 나눈다고 끝나지는 않습니다. 권한에 대한 결정 하나가 여러 일감과 문서에 영향을 줄 수 있기 때문입니다. 그래서 층(위계)과 연결을 함께 관리해야 합니다. 정보마다 적용 범위, 작성 시점, 현재 상태, 출처를 붙이고, 어떤 결정을 참고하거나 대신하는지 이어 두는 것입니다. 검색할 때도 문장이 비슷한지만 볼 게 아니라 권한, 최신성, 업무 관계를 함께 봐야 합니다.
여기서 말하는 ‘장기 기억’이 모델을 계속 다시 학습시킨다는 뜻일 필요는 없습니다. 결정과 사례를 바깥에 보관해 두었다가 필요할 때 찾아서 지금 일에 넣어 주는 것도 기억입니다. 반면 인사이트는 그 자료에서 새로운 패턴이나 더 나은 방법을 찾아내는 판단입니다.
기억을 무조건 따르게 하면 낡은 제약에 갇힙니다. 매번 새로 생각하게만 하면 이미 겪은 실패를 되풀이합니다. 균형을 잡으려면 검증된 원칙, 아직 검토 중인 가설, 이미 버린 결정을 구분해야 합니다. AI가 새 규칙을 제안하면 근거를 붙이고, 작은 실험이나 리뷰를 거친 뒤 공통 지식으로 올립니다. 요약에는 원본 링크와 아직 풀리지 않은 쟁점을 함께 남깁니다.
좋은 기억 체계는 결론을 짧게 줄여 주는 체계가 아닙니다. 필요할 때 이유를 되짚을 수 있고, 새 증거가 나오면 결론을 고칠 수 있는 체계입니다.
비유하자면...
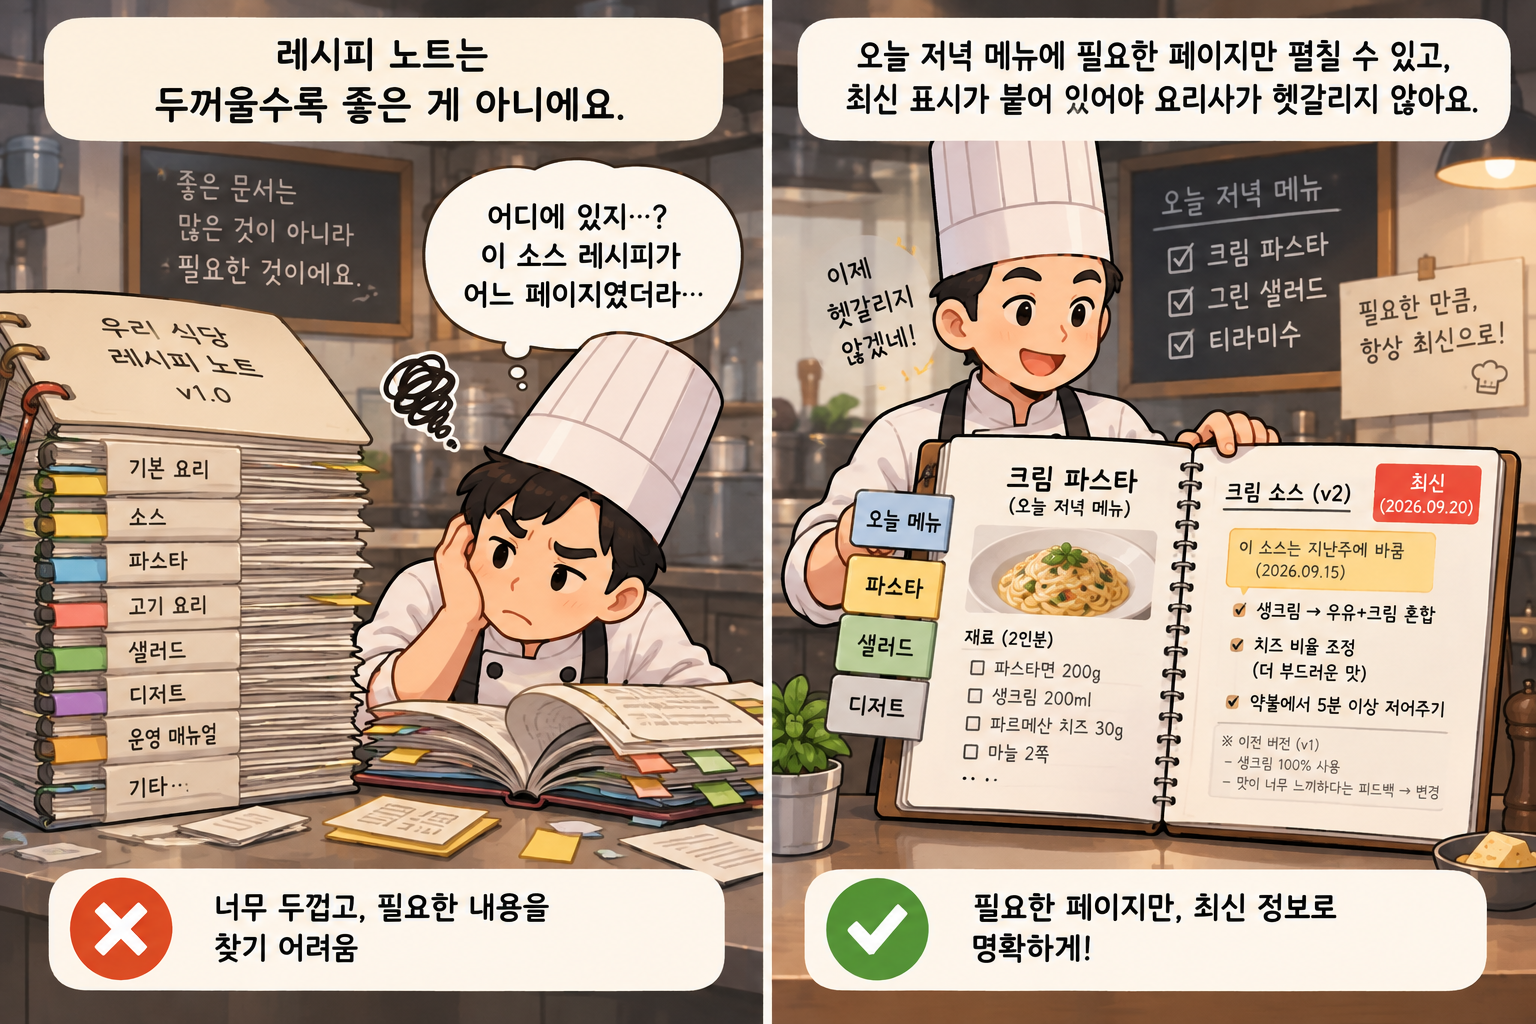
레시피 노트는 두꺼울수록 좋은 게 아닙니다. 지금 필요한 페이지와 최신 표시가 요리사를 헷갈리지 않게 합니다.
xKanban은 이 변화 속에서 어떤 자리에 있을까요?
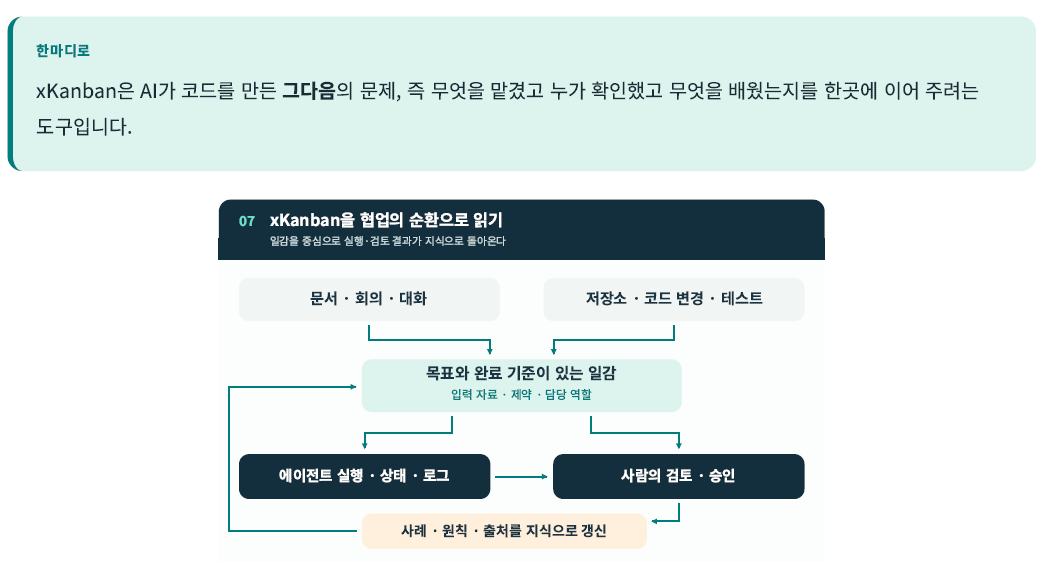
그림 7. Kanban의 협업 순환. 문서·회의·코드가 일감으로 모이고, 에이전트의 실행과 사람의 검토 결과가 지식으로 돌아와 다음 일감에 쓰인다.
xKanban은 업무, 일정, 문서, 파일을 한 곳에 모으고, 역할을 가진 AI 페르소나에게 실무를 맡기는 프로젝트 관리 플랫폼입니다. 회의 기록과 노트북을 일감에 연결하고, GitHub·GitLab의 이슈와 코드 변경(MR)도 프로젝트 안에서 함께 봅니다.
핵심은 ‘무엇을 단위로 일을 맡기느냐’입니다. 에이전트에게 긴 채팅을 넘기고 끝내는 게 아니라, 목표, 입력 자료, 제약, 완료 기준이 적힌 일감으로 맡깁니다. 실제 흐름은 다음과 같습니다.
- 칸반 보드에서 한눈에 봅니다. 일감은 Backlog → To Do → In Progress → Review → Done으로 움직이고, 스프린트와 우선순위별로 묶입니다. 에이전트가 어떤 일감을 실행하고 있는지 보드에서 실시간으로 보고, 필요하면 바로 제어할 수 있습니다.
- 일감을 위임해서 일을 시킵니다. 일감을 내 에이전트에게 위임하면 에이전트가 작업을 시작하고, 만든 MR이 일감에 바로 연결됩니다.
- 댓글로 이어서 지시하고, 말로 물어봅니다. 일감에 댓글로 후속 요청을 남기면 에이전트가 이어서 처리합니다. “XKANBA-693 위임 일감의 상태를 확인해 줘”처럼 채팅으로 물으면 현재 단계, 실행 상태, 남은 일을 정리해 알려 줍니다.
- 증빙이 붙은 보고서를 받습니다. 에이전트의 작업 보고에는 테스트 결과, 파이프라인 결과, 화면 캡처 같은 증빙이 함께 붙습니다. 작업 기록을 바탕으로 일일 업무 보고서 같은 정기 보고서도 정해진 시각에 자동으로 만들어집니다.
누가 무엇을 할 수 있는지도 분명합니다. Architect, Dev Lead, Developer, Backend Developer 같은 역할 템플릿마다 쓸 수 있는 도구와 일감 권한이 정해져 있고, 페르소나마다 소통 방식과 경험을 담은 전용 위키를 둘 수 있습니다. 페르소나를 움직이는 AI도 하나로 고정되지 않습니다. OpenRouter 같은 클라우드 API부터 Ollama, vLLM, Furiosa NPU 위에서 돌아가는 로컬 LLM까지 여러 AI제공자를 한 곳에서 관리하고, 페르소나마다 알맞은 모델을 지정합니다. 인간 사용자를 대리하는 개인 에이전트로 내가 실무에 사용하던 Claude Code나 Codex를 연결해 쓸 수도 있습니다.
장기 기억도 제품의 한가운데에 있습니다. xKanban의 지식 기반은 AI 에이전트와 사람이 함께 만들고 가꾸는 LLM 위키입니다. 구조(architecture), 운영 수칙과 함정(operations), 변경 기록(logs)을 나눠 두고, 스스로를 ‘정답’이 아니라 현재 코드와 테스트로 안내하는 색인으로 다룹니다. 실제로 무언가를 바꾸기 전에는 늘 지금의 코드, 테스트, 운영 환경을 다시 확인하는 것입니다. 위키 요약(Digest)과 기억 추출은 결정론적인 시스템의 고질적인 문제인 확증 편향을 막기 위해 원본 기억(일감 로그)을 사용하고, 시스템과 함께 진화하는 AI 에이전트가 맡습니다.
지식 기반을 가꾸는 원칙도 정해 두었습니다.
✓ 반복해서 쓸 사실만 골라 남긴다.
✓ 근거가 되는 코드, 테스트, 검증 시점을 연결한다.
✓ 같은 사실은 한 곳에만 두고, 다른 문서에서는 링크로 건다.
✓ ‘현재 적용 중 / 아직 미구현 / 제안 / 미확인’을 구분한다.
✓ 새로 확인한 사실이 없으면 문서를 억지로 늘리지 않는다.
무엇을 기억할지뿐 아니라 무엇을 더하지 않을지까지 정한다는 점에서, 앞 장에서 말한 균형을 실제 운영 규칙으로 옮긴 셈입니다.
맥락이 새는 곳도 막습니다. 회의 영상이 녹취록이 되고, 녹취록이 회의록이 되는 과정에서 정보는 조금씩 빠지기 쉽습니다. xKanban은 원본 미디어, 화자가 구분된 녹취록, 회의록을 서로 연결해 한 체계 안에서 관리합니다. 회의록을 보다가 궁금한 대목이 생기면 녹취록과 원본 영상으로 바로 되짚어 볼 수 있습니다.
자동완성 도구는 코드를 쓰는 부담을 줄였고, 코딩 에이전트는 맡길 수 있는 일의 범위를 넓혔습니다. 이제 팀에 필요한 건 무엇을 맡겼고, 어떤 근거로 했고, 누가 확인했고, 다음 일에 무엇을 남겼는지를 이어 주는 구조입니다. xKanban은 개발자뿐 아니라 프로젝트 관리자, 기획자, 디자이너도 이 흐름에 함께 참여하게 합니다.
물론 이런 문제를 xKanban만 다루는 건 아닙니다. 기존 개발 플랫폼들도 작업 위임과 팀 운영 쪽으로 넓어지고 있습니다. 그래서 차별점은 실제 효과로 드러나야 합니다. 맥락을 찾는 시간이 줄었는지, 인수인계가 쉬워졌는지, 같은 실수가 줄었는지가 그 기준입니다. xKanban의 의미는 코드 생성 이후에 더 커지는 협업과 기억의 문제를 제품의 한가운데에 두었다는 데 있습니다.
비유하자면...
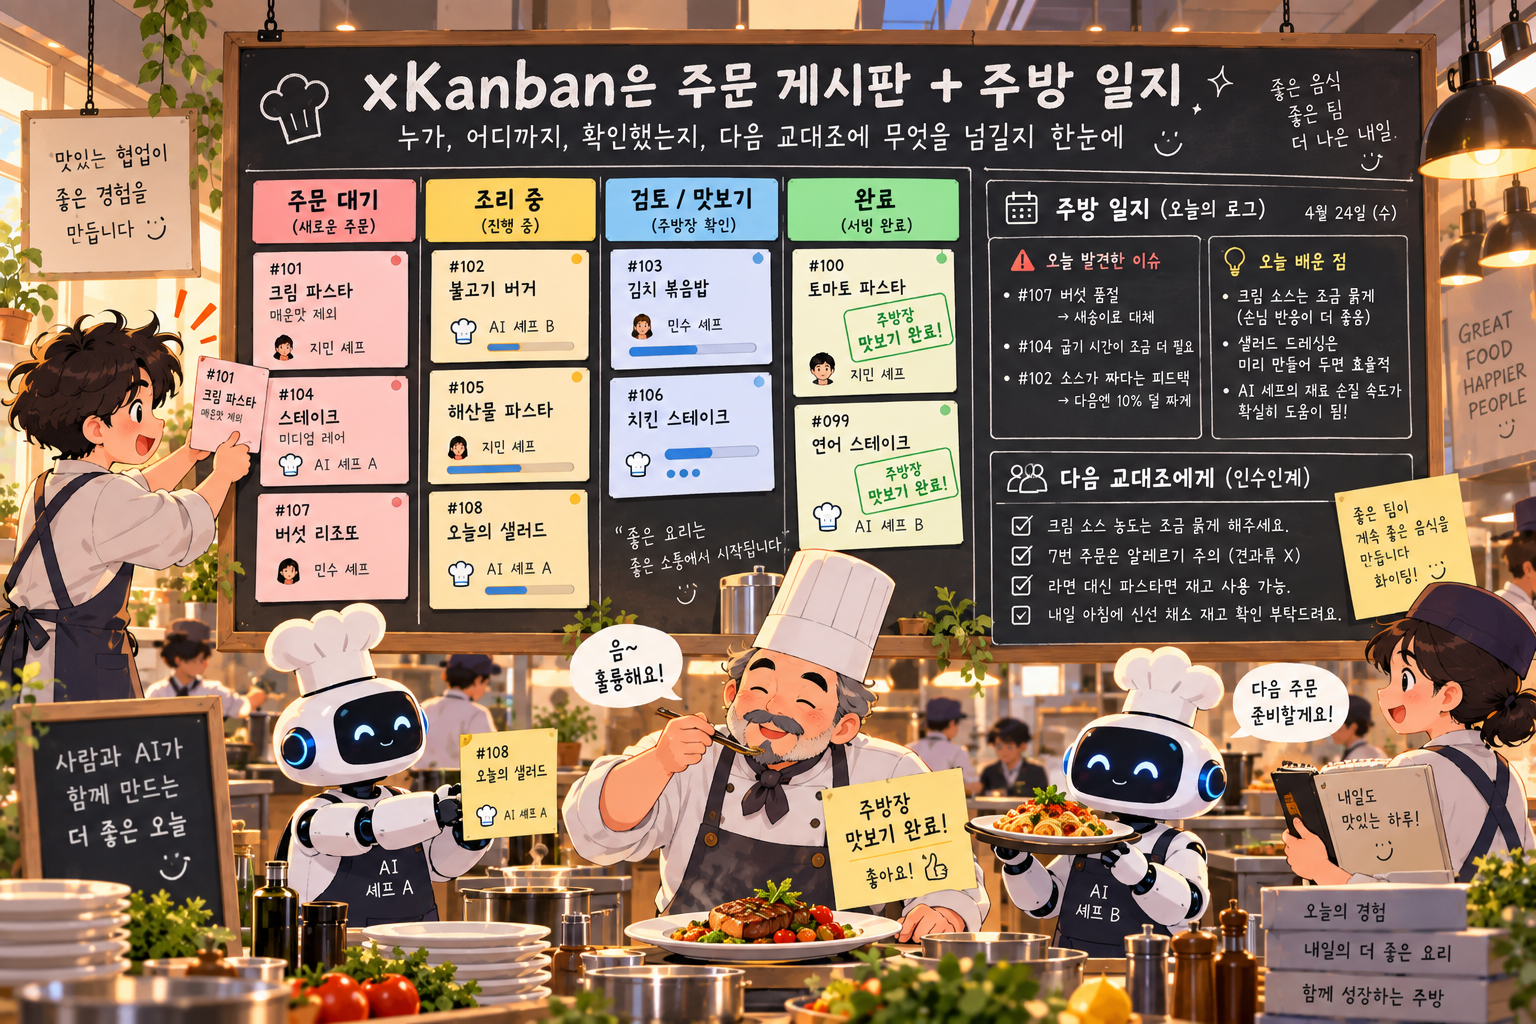
누가 어떤 주문을 어디까지 했는지, 주방장의 맛을 봤는지, 다음 교대조에 무엇을 넘길지가 한눈에 보입니다
오래가는 업무 혁신은 무엇부터 바꿔야 할까요?
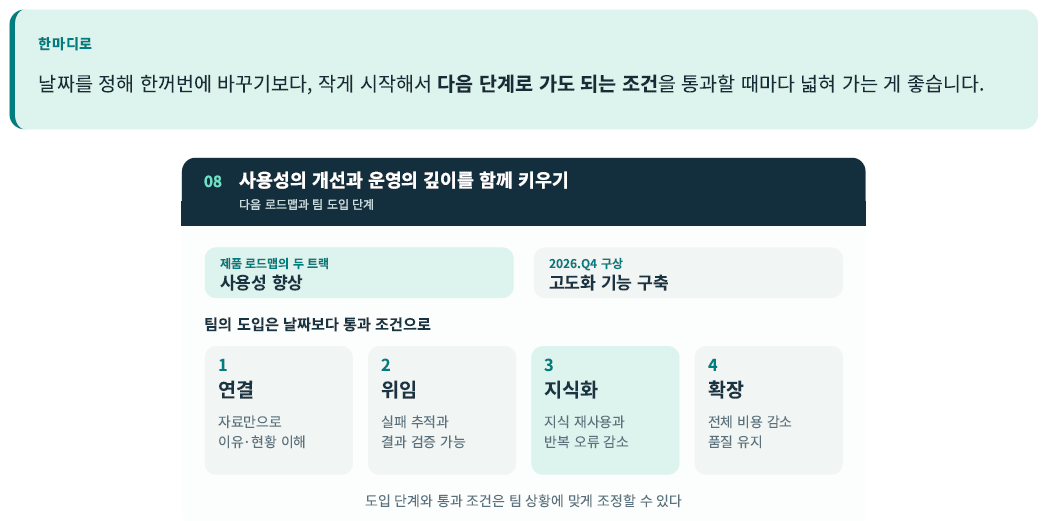
그림 8. xKanban 2026년 4분기 로드맵의 투 트랙과, 이를 팀에 들이는 네 단계.
xKanban의 다음 계획은 ‘사용성 향상’과 ‘고도화 기능 구축’ 두 갈래를 나란히 진행한 뒤 하나로 합치는 계획입니다. 앞에서 한 이야기와 잘 맞습니다. 처음 연결하기가 어려우면 사용자는 떠나고, 오래 써도 일이 정리되지 않으면 팀은 도구를 믿지 않습니다. 쉽게 시작할 수 있는 힘과 깊이 운영할 수 있는 힘이 함께 자라야 합니다.
보고와 증빙은 이미 자리를 잡았습니다. 작업 기록으로 정기 보고서를 자동으로 만들고, 에이전트는 테스트 결과와 화면 캡처를 붙여 결과를 보고합니다. 이제는 처음 시작하는 부담을 줄이는 쪽에 힘을 싣고 있습니다. 개인 에이전트의 도움을 받아 목표, 산출물, 마일스톤, 예산, 실적, 변경 이력을 정리하는 프로젝트 생성 마법사, 더 쉬운 개인 에이전트 설치, 보고서 버전 관리, 문서 스냅샷, 실패한 실행의 재시도 같은 기능입니다. 계획이 구체적인 운영 과제로 내려오고 있는 것입니다.
이 방향을 실제 업무 변화로 옮긴다면 아래 순서를 추천합니다. 날짜부터 박아 두기보다, ‘다음 단계로 넘어가도 되는 조건’을 먼저 정하는 로드맵입니다.
첫 실험은 거창하지 않아도 됩니다. “회의록을 보고 후속 일감을 제안하면 사람이 확인한다”, “범위가 좁은 버그를 고치고 재현 테스트를 붙인다” 정도면 충분합니다.
익숙한 업무에서 성공과 실패를 비교해 봐야 무엇을 더 맡길지 판단하기 쉽습니다.
대시보드에서 보는 숫자도 바뀌어야 합니다. 만든 코드의 양이나 돌린 에이전트 수보다 아래 숫자가 더 쓸모 있습니다.
✓ 일감 하나가 끝날 때까지 걸린 시간
✓ 검토를 기다린 시간
✓ 다시 작업한 횟수
✓ 같은 오류가 다시 생긴 횟수
✓ 담당자가 맥락을 파악하는 데 걸린 시간
AI 사용료와 사람의 검토 시간도 함께 봐야 합니다. 그래야 비용이 정말 줄었는지, 다른 곳으로 옮겨 갔을 뿐인지 알 수 있습니다.
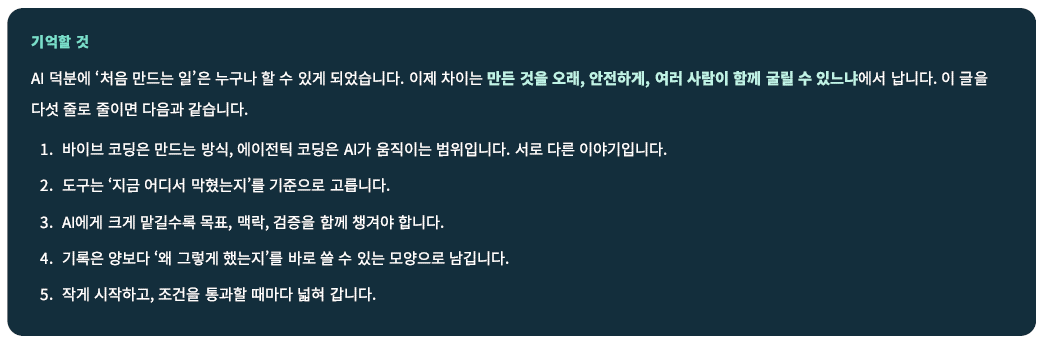
바이브 코딩은 더 많은 사람에게 만드는 즐거움을 열어 주었습니다. 에이전틱 코딩은 AI에게 맡길 수 있는 일의 범위를 넓히고 있습니다. 그다음 단계는, 팀이 매번 처음부터 설명하지 않아도 경험을 쌓아 가며 더 나은 일을 하는 것입니다.
xKanban이 풀어야 할 과제도 여기에 있습니다. 오늘의 일감과 실행 결과가 내일의 판단에 쓰이도록 이어 주는 것. 사람이 바뀌고 에이전트가 바뀌어도 프로젝트가 자기 맥락을 잃지 않게 돕는 것. 이 연결이 꾸준히 작동할 때, AI 활용은 반짝 효과가 아니라 조직이 계속 나아지는 일하는 방식으로 자리 잡을 수 있습니다.
참고 자료
웹 참고 문서
- GitHub, Introducing GitHub Copilot: your AI pair programmer, 2021-06-29. 초기 코드 제안 방식과 공개 시점.
- GitHub, GitHub Copilot X: The AI-powered developer experience, 2023-03-22. 개발 환경 안의 대화형 지원.
- Cognition, Introducing Devin, the first AI software engineer, 2024-03-12. 실행 환경과 작업 위임의 역사적 사례. ‘first’는 원문 제목이며 이 글의 독립적 판정이 아니다.
- Anthropic, Claude 3.7 Sonnet and Claude Code, 2025-02-24. Claude Code 연구 프리뷰와 도구 실행.
- OpenAI, Introducing Codex, 2025-05-16. 클라우드 기반 작업 위임의 발표. 현재 제품 안내와는 구분.
- Simon Willison, Not all AI-assisted programming is vibe coding (but vibe coding rocks), 2025-03-19. Karpathy의 원문을 인용하며 용어와 책임을 구분한 당사자의 논의. 원 게시물: Andrej Karpathy의 X 게시물.
- Lovable, Welcome to Lovable. 자연어 앱 개발, 수요층과 외부 저장소 연계.
- Replit, Replit Agent. 프로젝트 구성, 구현, 테스트와 배포 흐름.
- Cursor, Agent overview. 코드베이스에서의 에이전트 작업.
- GitHub Docs, About GitHub Copilot cloud agent. 비동기 작업과 결과 검토.
- Cursor, Scaling long-running autonomous coding, 2026-01-14. 다수 에이전트의 조정 실험과 한계.
- Martin Fowler, Agentic Programming 및 Vibe Coding, 2026-05-21. 생성된 코드에 대한 이해와 책임.
- GitHub, Spec Kit 저장소. 명세·계획·작업을 연결하는 개발 접근.
- Anthropic, Building effective agents, 2024-12-19. 단순하고 조합 가능한 작업 구조.
- METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, 2025-07-10. 특정 환경의 무작위 대조 실험과 일반화의 한계.
- METR, We are Changing our Developer Productivity Experiment Design, 2026-02-24. 후속 연구의 선택 편향과 측정 한계.
- Nelson F. Liu 외, Lost in the Middle: How Language Models Use Long Contexts, 2023. 긴 입력에서 정보 위치와 성능의 관계.
- Anthropic, Effective harnesses for long-running agents, 2025-11-26. 세션 사이의 인수인계와 검증.
- Anthropic, Effective context engineering for AI agents, 2025-09-29. 제한된 맥락의 선별과 관리.
xKanban
서비스: https://xkanban.kr/
삽입 이미지
그림 1–8은 이 글을 위해 새로 제작한 SVG 도해이고, 식당 비유 일러스트 8점도 이 글을 위해 새로 만든 이미지(ChatGPT Image로 생성)입니다. 각 도해 아래에 참고 자료를 표시했습니다.
원문: AiNEWT 기술블로그